标准、边界和验收本身,才是 Skill 的复用价值
Skill 就是写给 AI 的操作说明书
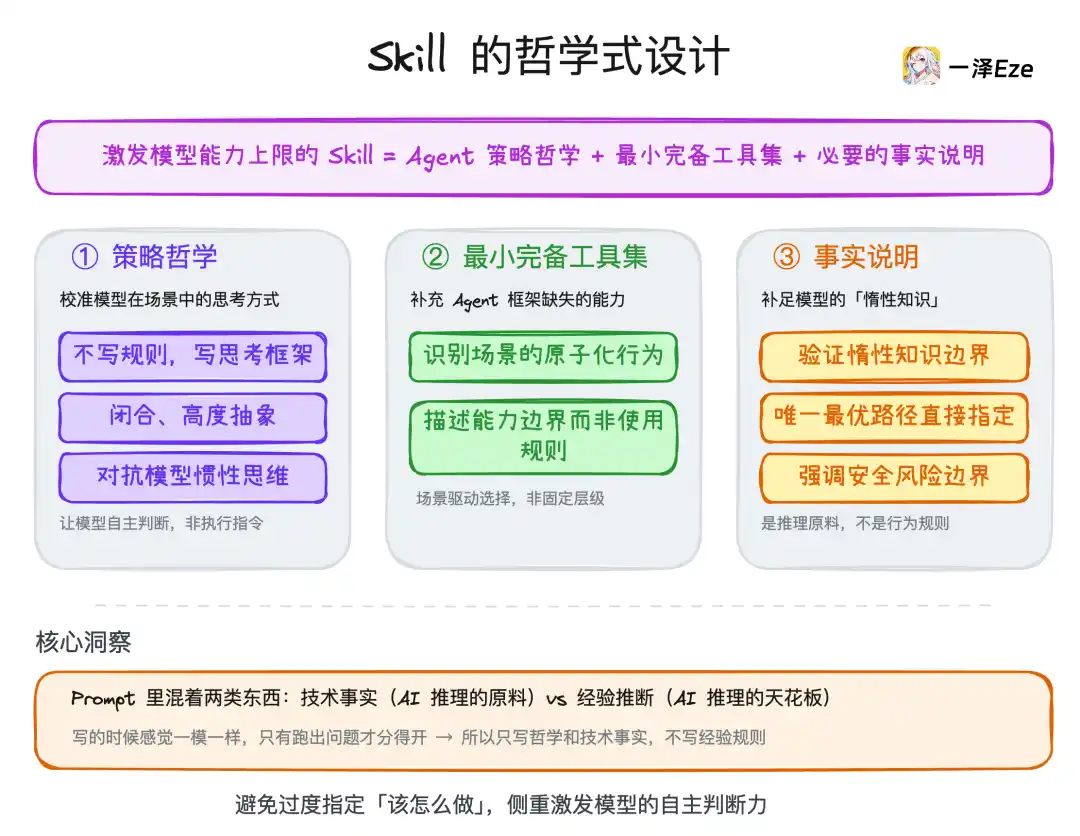
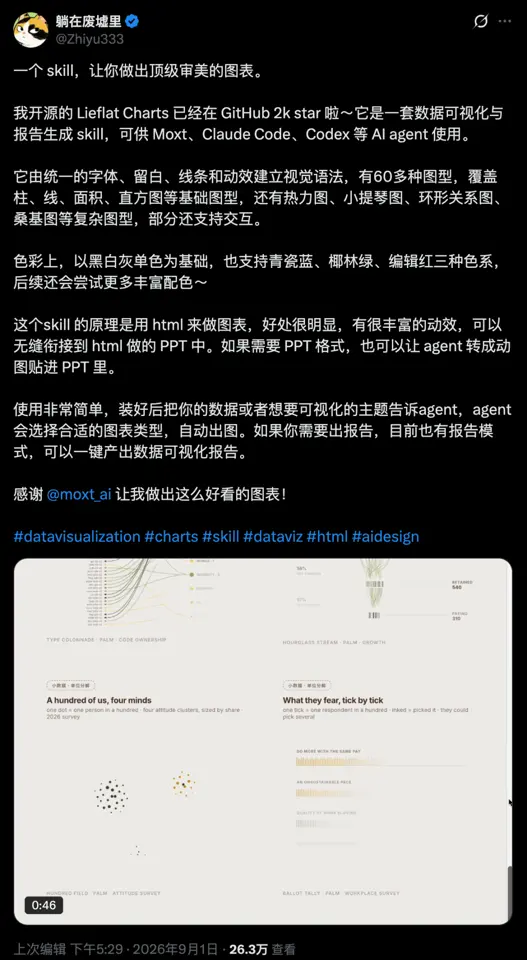
有一段时间,我曾经很沉迷于寻找所谓的“经验”。各个渠道只要刷到看似经验的内容,都会保存一波,颇有点“松鼠症”的味道。也因为如此,开始用 Claude Code、OpenClaw 这些工具的时候,正经事没干多少,工具反而先装了一堆————所谓“差生文具多”的典型了属于是。后来逐渐开始精简,相同类型的工具合并,只留下自己真正需要的。同时也会根据工作、生活里的使用情况,先找个任务跑几圈,看看执行情况,再决定留下、调整还是优化。在这个基础上,我留下了一些写作、办公类 Skill,也在吸取其他人大量经验的基础上,做了几个适合自己工作流的 Skill。最开始我对 Skill 的理解很简单,以为就是创建一个 SKILL.md 文件,把说明区域写好,做好渐进式披露,问题应该不大。3 月的时候,一个朋友在群里说,他自己开发了一个写研究报告的 Skill,效果能达到商业报告的 90% 以上。内容已经不太记得是那些了,重点还记得,说的就是:预设。当时有个说法是大模型能力取决于语料,就是“垃圾进垃圾出”,如果输入不对,那输出也不对。如果是写报告之类的技能,在搜集资料的阶段,搜集到的都是垃圾信息,那出来的报告必然垃圾。所以在搜集阶段,一定要保持输入源的准确和有效。所以他的技能里其实写了很多规则和限定,而不是上来就让AI去全网搜索一堆垃圾。另一个朋友写的 Web Access Skill,给了我更多启发。激发模型能力上限的 Skill = Agent 策略哲学 + 最小完备工具集 + 必要的事实说明。 图2 Web Access的设计原理 图源@一泽Eze通用场景的 Skill 或 Prompt,不应该把 Agent 每一步“该怎么做”都规定死。更重要的是重新校准它在这个场景里的策略,补上它缺少的基础工具,再把那些显然知道、但执行时未必能第一时间想起来的事实提前说明。当时不太理解“策略哲学”这个说法(念书的时候哲学就不怎么好,哈哈哈),但这个 Skill 一直在用,后来慢慢明白了一点:它真正想解决的,不是联网工具够不够多,而是 Agent 遇到任务时,能不能选对方法,并且知道什么时候该换路、什么时候该停。Web Access 里有一套很清楚的循环:拿到任务先定义成功标准;选一个最可能直达的方式作为起点;把每一步的结果当作证据,根据结果调整计划;最后对照成功标准确认完成。它还把“搜、看、做”需要的基础工具补齐,并让 Agent 记录站点经验,下次访问时跳过已经踩过的坑。[1]昨天在 X 上又看到一套叫 Lieflat Charts 的图表 Skill(之前刷到过,没怎么注意),打开仓库看了一下,发现挺有意思。作者说,它用统一的字体、留白、线条和动效,建立了一套自己的视觉语法;给 Agent 数据或主题,它会自己选图表、出 HTML,也可以继续生成整页报告。[2]Skill 里很多内容不是“我能画 60 多种图”,而是“哪些情况不要这样做”:- 默认只出图表,不因为用户说了“分析”就自动升级成报告;
- 一根线、一个点背后要有真实数据,纯装饰不能随便加交互;
这些规则和图表代码没有直接关系,却决定了最后的图是在帮人判断,还是只是在屏幕上摆一些好看的东西。我想起了开始学习 Skill 时听过的一种说法:Skill 就是写给 AI 的操作说明书(SOP)。操作说明要说明流程,要限制边界,要达到一个新人拿到这个文件都能知道怎么做,做到什么程度的效果。但真的跑起来,我们手里的买家秀和开发者手里的卖家秀,就不是一个东西。小红书上有个说法,Skill 有点类似带新人。你不会只跟一个刚入职的人说:“去做一张好看的图。”这句话实际上什么都没有交代——他还不知道这张图给谁看,数据应该怎么理解,哪些模板可以用,哪些看起来漂亮但不诚实,什么情况下要回来问你,最后交一个什么样的文件才算完成。写 Skill 也是一样。画图、写代码、整理资料、生成 PPT,现在基本上是个AI都能搞定(哪怕是网页版对话式的,也能像模像样给你编一个),但如果你不告诉他给谁看,数据是那些,用不用模版,给你的也是一堆不能用的垃圾。所以我在新建、修改SKill的时候,会特别注意这两个,特别是:边界。我让 AI 执行的事情其实很随机,内容也千奇百怪。比如让它分别研究小红书、公众号和知乎上的文章,再汇总成一份报告。每次要研究的对象、网页数量、平台组合都可能不一样,我不可能为每一种情况预先写死一套步骤。但输出端可以有明确规范:资料来源要能回查,结论不能拿搜索摘要硬凑,数字要回原文,报告要能说明覆盖范围和遗漏,遇到不确定的地方要停下来说明。我要做的,就是把这些验收标准写进去,再考虑边界情况。这和“多写几个工具调用步骤”不是一码事。步骤面对的是已知路径,标准面对的是变化的任务。任务变了,动作可以换;只要最后仍然满足标准,这个 Skill 才有复用价值。我自己的一系列 Skill,也是这样慢慢改出来的。最开始我以为,写作 Skill 就是把写文章的步骤列出来:资料找完,文章写完,再改一遍,差不多就这样。后来真实跑了几次,发现自己太理想化了,结果造就了一堆废稿。不是 AI 不会写,而是AI会把 Skill 当成说明书。它读了入口文件,后面很多地方还是凭记忆往下跑,脚注、采集和核验都出了问题。后来我才陆续补上前置条件:进入对应路径前先读指定的说明,外部事实和数字回原文,规则只保留一个权威源,资料闸门没过不能进草稿。这些要求看起来都挺烦(而且写在文件里也不代表AI每一次都会去听,Claude经常干这事儿),但它们解决的不是“AI 会不会写”,而是“AI 有没有资格开始写”。复用的不是某一次任务的操作顺序,而是面对一类任务时,哪些判断可以提前保存下来。什么时候调用,先看什么,什么情况要换方法,什么东西不能碰,做到什么程度才算交付,这些才是跨任务、跨输入还能留下来的部分。所以我现在新建或修改 Skill,优先看三件事:标准、边界、验收。- 标准,是这类任务到底要追求什么,不要只写“做得好”;
- 边界,是哪些事情可以自己判断,哪些事情必须换一种方法,哪些事情绝对不能做;
- 验收,是拿什么证据判断它真的完成了,而不是听它说“已经做好了”。
Agent Skills 官方的评测文档也要求,测试用例要写清任务、成功结果和输入文件,并把有 Skill 与没有 Skill 的结果放在一起比较;好的断言应该具体、可观察、能验证,机械事实优先用脚本检查,主观质量再交给模型或人判断。[4]没有规矩,Skill 写得越长,越像一份堆满经验的说明书;有了规矩,任务即使换了输入、换了平台、换了工具,AI也还能知道自己有没有跑偏。[1]: 一泽Eze,《Web Access:一个Skill,拉满Agent联网和浏览器能力》,微信公众号,2026-03-23,https://mp.weixin.qq.com/s/rps5YVB6TchT9npAaIWKCw[2]: @Zhiyu333,Lieflat Charts:一套数据可视化与报告生成 Skill,X,2026-09-01,https://x.com/Zhiyu333/status/2094719194302706136[3]: Lieflat Charts,《SKILL.md》,GitHub,访问 2026-09-02,https://raw.githubusercontent.com/larashero3-dotcom/lieflat-charts/main/SKILL.md[4]: Agent Skills,《Evaluating skill output quality》,Agent Skills,访问 2026-09-02,https://agentskills.io/skill-creation/evaluating-skills