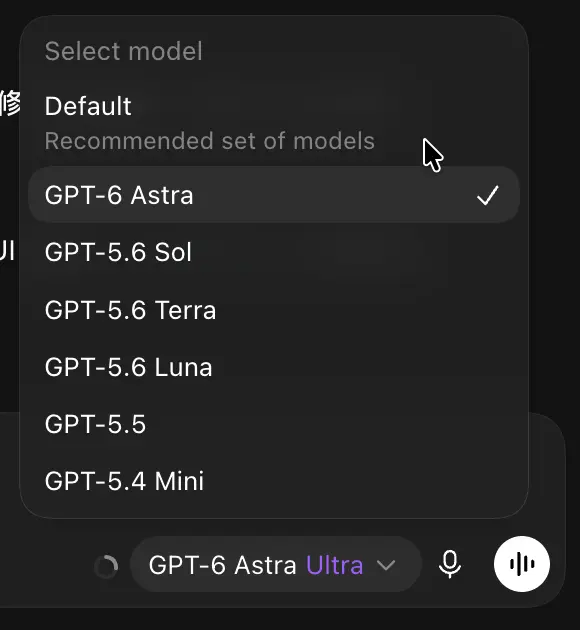
周末OpenAI 发布了 GPT-6 Astra。各家的评测都是模型变强了很多,甚至在媒体闭门会上,Greg Brockman 喊出了“欢迎来到AGI时代。”的口号。但官方和营销号都在说要求你删除提示词,更新AGENTS文件,到底是怎么回事?这篇按「提示词 → AGENTS 文件 → 子智能体 → 额度」走一遍。每一块都是能直接上手的方法,基于我本地电脑上实际改过、试过的东西。图1 GPT-6 Astra上线,需要更新ChatGPT版本才能看见过去大家的提示词都追求“完美”,想要一次性把提示词写对让AI直接执行,有问题先问用户再去执行;这就导致AI在执行的过程中,一会就卡住(Claude就是典型代表)问用户,得到反馈后才能继续。官方原文是这么说的:当指令留了解释空间,它用上下文自己填补那些常规的空缺,只有当答案可能改变结果时,才问一个聚焦的问题。[1] 换句话说就是:它终于学会了判断——该自己干的自己干,该问的才问。从指令和上下文里推断用户的意图和任务范围。你的任务是偏向行动,把用户想要的任务推进到完成。当用户的提示表达了行动请求("能不能帮我…""我想…"),把它当成"去做这件事"的指令,不要停在"我可以帮你"或者给个方案上。如果任务需要持续工作,就做完所有必要的工作,直到目标达成。在问用户澄清问题之前,先把上下文里已经授权、且能让下一步变成具体可审查结果的工作做完。用户要批准的是一个具体、可检查的结果。可逆的任务、只读操作、检查、修复、以及会话里已经授权的事,不需要再要许可。
中译中是:别让它一上来就问你,先让它把能做的做完,只把真正要拍板的事留到最后问。 这与旧提示词"有任何不确定就先问我"是完全反着来的。写作类任务还有一条官方给的模板,专门治"套话"和"AI 味":直接说出你要做的动作。别写"我不会做什么""什么保持不变",别用"X,而不是 Y"这种对比句式,别造"精确标题检查""编辑式排版"这类自创标签,少用模糊限定词和套路过渡,用朴素的动词和介词把关系说清楚。
你想要公众号、小红书那种自然风格,就把上面这段喂进去。[2]官方文档里明写了 Astra 的三个行为特点,每一条都直接指向你旧文件里的问题:
- 主动性与持续完成(Initiative and follow-through):它更可能在需要你拍板时停下来问——包括在你其实希望它自己做个合理假设继续干的时候。
- 指令遵循(Instruction following):它比旧模型更擅长遵循指令,也就对 skills、AGENTS.md 这类文件里的内容更敏感。官方原话是:强烈建议审计你的 skills 和其他文件里可能影响它行为的指令。
- 测试与验证(Testing and verification):写代码时它倾向于把测试做得很彻底,小任务也可能跑出超出需要的测试。
简单理解就是:它太把你的规则当回事了。旧规则里那些模糊的"谨慎",在旧模型上是保险,在 Astra 上会变成枷锁。 | | |
|---|
| 连"帮我修一下"都要先来一轮目标访谈,输出文件名也要等你拍板 | 低风险、可逆的,说明假设直接做;只有真影响目标或不可逆时才问 |
| 没定义什么叫"高影响",多改几个文件也被当成高影响 | 写清楚:高影响 = 不可逆、对外发布、付费、账号权限、隐私 |
| | |
如果不想自己逐条看,官方给了个更聪明的办法——让 Astra 自己揪出是哪个文件、哪条规则在让它停下来:如果某个 skill 让你去申请许可、要求确认、停下手头没做完的活、或者偏离用户意图,说出并链接到你读的那个 SKILL.md 文件,引用相关指令,简短解释它是怎么影响你的。把 skill 的明确要求和你的解读区分开。
下面这条社区验证过的审阅提示词,可以直接用:[3]审阅我的 AGENTS.md 文件和 Skill,寻找不清晰的、冲突的或重叠的指令,这些指令可能会让你不必要地停止、要求多余的确认,或者让工作不完整。将有意设置的保障措施与那些意外地让常规工作需要确认的措辞区分开来。对于每个问题,引用相关的指令,识别文件,解释它们如何可能影响你的行为,并提出具体的编辑建议。保留明确的批准要求,并指出任何提议的变更会扩展你的权限。我这次一共扫了 2837 个文件(34 个 AGENTS.md、2803 个 SKILL.md,去重后 2335 份),审出 29 项这类问题,改了 49 个文件。如果你想要一份现成的文件内容,卡兹克在 Astra 发布后重写的这版 AGENT.md 可以直接更换,六节全文如下:[4]- 面向用户的叙述默认使用简体中文;代码、命令和技术标识保持英文。- 先给影响与结论,再给行动、待决策和必要证据;没有对应内容就省略。- 使用简洁、连贯的段落;只有确实适合并列比较或按步骤执行时才使用列表。- 使用具体、简单的词,避免无意义术语、套话、重复总结和未经请求的对比。- 技术细节只保留对理解结论、判断风险或复现结果有帮助的部分。- 用户当前明确指令优先于 Skill、历史记忆和默认偏好。- 项目目录中的 AGENTS.md 只在该项目范围内补充或覆盖全局规则。- 用户表示要开始新工作或修复现有问题时,持续推进,直到用户的目标完成,在目标方向上自主推进。- 向用户提问之前,先完成上下文里已经授权、并且能把下一步变成可审查结果的工作。用户批准的应该是具体、可检查的结果。- 不要因为假想风险,主动加警告、免责声明、审批流程或安全/合规清单。- 不要为可逆、影响小、只是复述实现的改动写测试。- 跑与本次改动相称的测试,并完成必要检查。通过之后,只有出现新改动、新失败或尚未解决的疑点时,才扩大或重复测试;否则继续把任务做完。- 搜索文件或文本优先使用 rg、rg --files;独立的读取和查询尽量批量执行。- 网页控制台无 CLI/API 时用已登录的 Chrome 浏览器;飞书优先 lark-cli。- 只有存在真正独立的工作流,且委派能节省时间或提升质量时才使用子 Agent。- 共享状态、连续决策和简单任务由当前 Agent 直接完成;委派任务必须有明确输入、输出和完成判据,最终结论由主 Agent 汇总并验证。- 全局规则维护在当前生效的 canonical AGENTS.md;CLAUDE.md 只作兼容入口,不复制规则正文。- 项目事实、生产状态、历史决策和对外契约以项目级 AGENTS.md 及其指定的脚本、探针、决策记录和合同文件为准。但有一条底线别动:发布、删除、付费、账号权限、作者归属,这些规则不是要放开,还是要保留。改的是"已授权范围内的实现裁量",不是"让 AI 想干嘛干嘛"。Astra 自带"多智能体编排"的能力,能把活拆给并行工作的子智能体。官方给的提示词是:
任何时候,只要能把工作并行起来、委派给另一个 agent(不管你是根还是子 agent),只要它能省时间或提质量,就用协作工具去做。
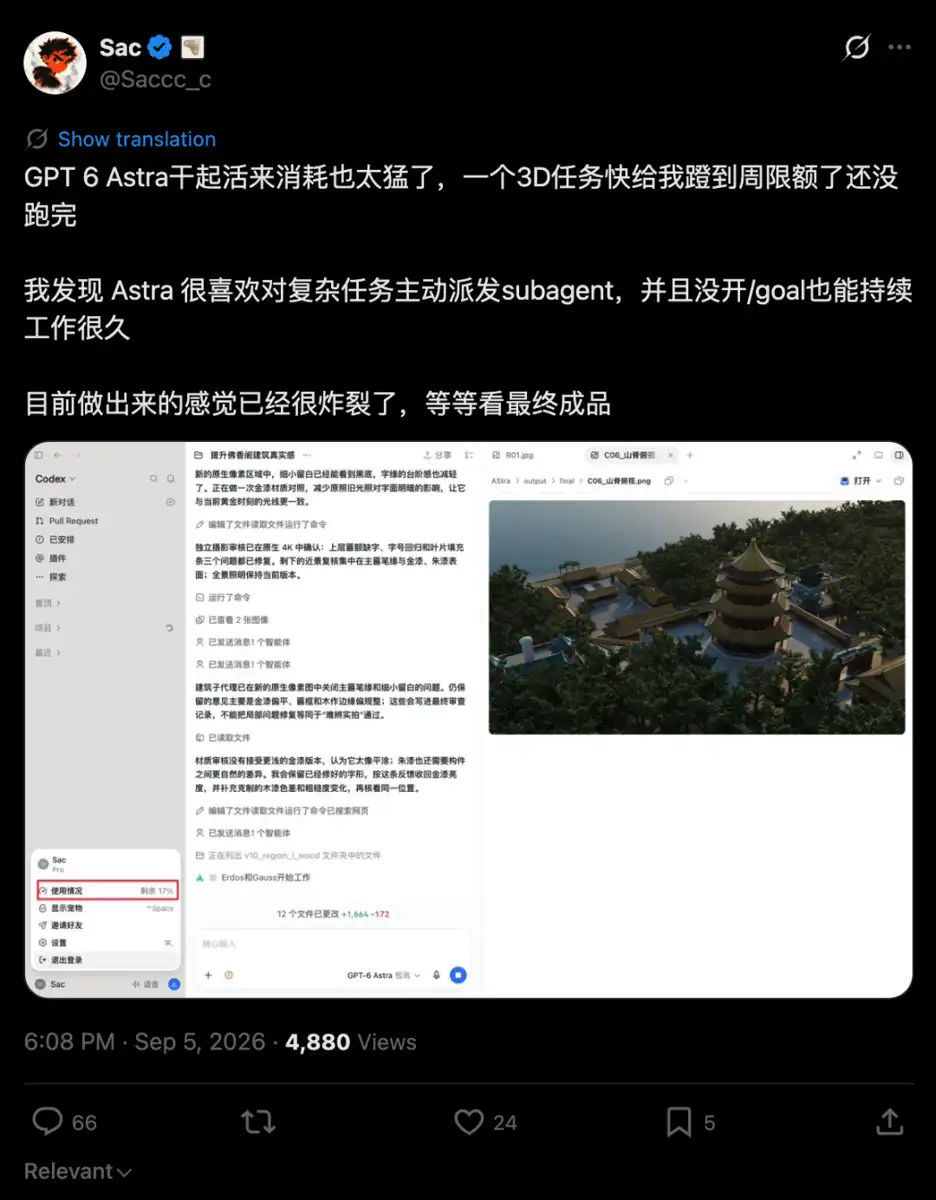
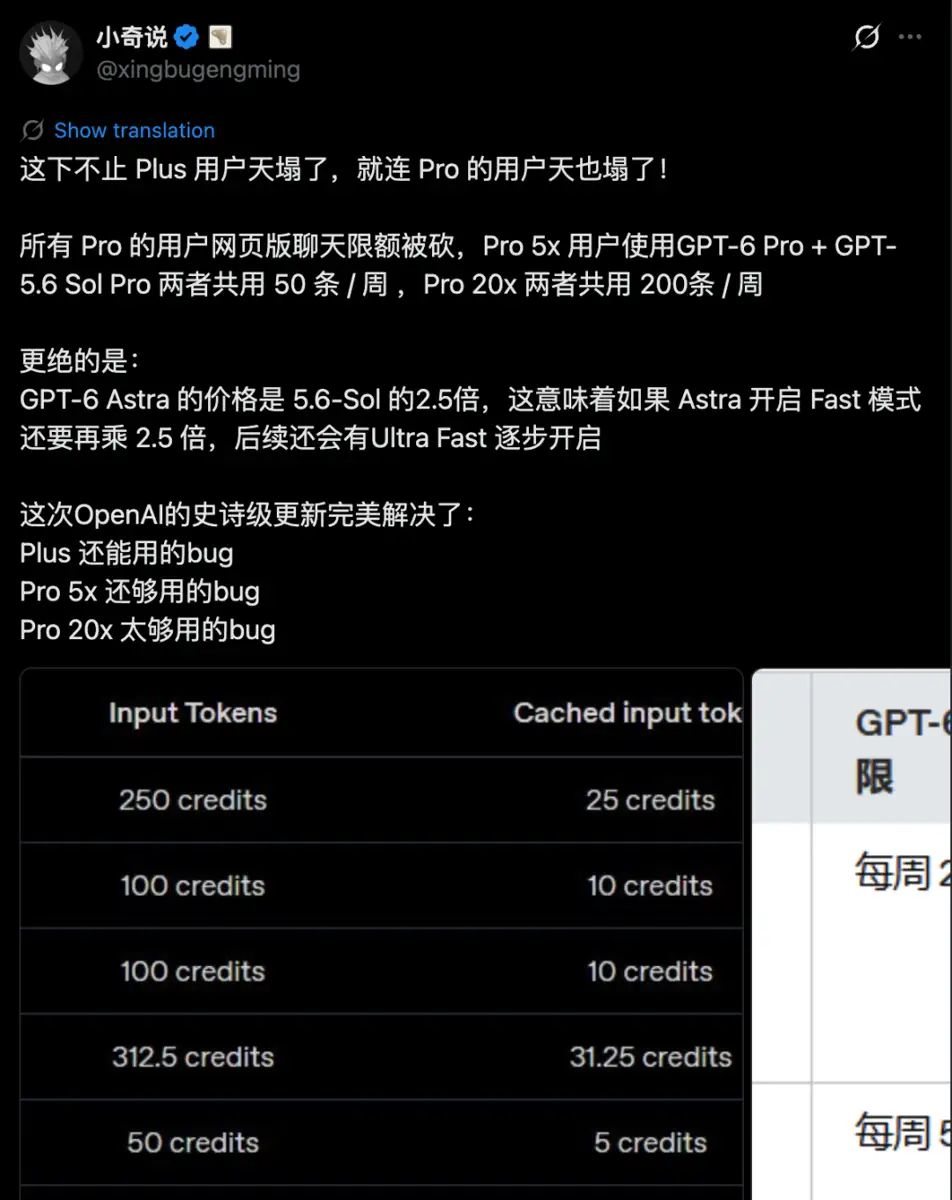
第一,5.6 开始,Codex 的子智能体从"可以聊天的同事"变成了"用完就扔的临时工"。[5] 5.5 那会儿你能点进去跟它聊、管它用哪个模型;5.6 开始它没有对话入口,只让你看它干了什么。所以老线程的任务要迁移:让它先总结一份交接文档,新建线程,把交接文档复制进去继续干。不迁移,就一直是旧的子智能体逻辑。5.5 的子 agent 调用积极性很差,怎么催都不动;5.6 把这块训好了,一个复盘指令能开出 5 个一级子 agent、25 个二级子 agent,Pro 20 的额度只撑了 50 分钟还没跑完。[6] 所以子智能体和额度要放一起管:让它并行可以,但要知道它在烧额度,该收就收。第三,也是最省心的:别再折腾"怎么管理智能体"的技巧了。官方这轮的思路是 AI 自己管自己的"招聘",你负责提需求就行。[5]这里注意:Astra 有两套计算方式,我们使用的Pro、2X 这些套餐用的是"条数"那套,不是"token"那套(这是给开发者或者企业用户计算的)。订阅制(按条数计算) 指的是 ChatGPT Pro 或 Plus 订阅,额度按"多少条/周"算,跟 token 没关系:- Pro 20x($200/月):GPT-6 Pro 和 GPT-5.6 Sol Pro 共用 200 条/周
- Pro 5x($100/月):两者共用 50 条/周
- Plus($20/月):普通 Chat 里没有 Astra,只在 Work 和 Codex 给一点有限额度
对订阅用户,"省"就一句话:Astra 的条数金贵,别浪费在零碎任务上。 大型任务(搭架子、做规划)用 Astra 或 Sol 跑,改 bug、小修小补用 Terra。别忘了前面说的:子智能体一开就是烧条数的大头。一个复盘指令开出 5 个一级、25 个二级子 agent,Pro 20 的额度只撑了 50 分钟。[6]- Pro 20x 的 GPT-6 Pro 独享 200 条/周;Sol Pro 另有 170 条/天,但两者合计每天最多 200 条
- Pro 5x:6 Pro 和 Sol Pro 共池,50 条/周
API 计费(计算 Token 消耗量), 开发者才按 token 算钱:[7]GPT-5.6 Sol 是输入 4 美元、输出 20 美元,[9] Astra 正好 2.5 倍。官方说法是 Astra 用更少输出 token 完成任务,单任务实际成本反而更低。
1. 推理强度别拉满,可以中途动态调。 五档:low、medium、high、xhigh、max。日常"中""高"够了,难的活调高、收尾调低,官方支持中途改强度不用重写提示词。我机器上就从 xhigh 调到了 medium (实在是跑不起了)。2. 别开 Fast,除非真赶时间。 Fast 价格 2 倍;单次输入超 272K token,整次请求输入和缓存 2 倍、输出 1.5 倍;能等的任务走 Batch,标准价的 50%。
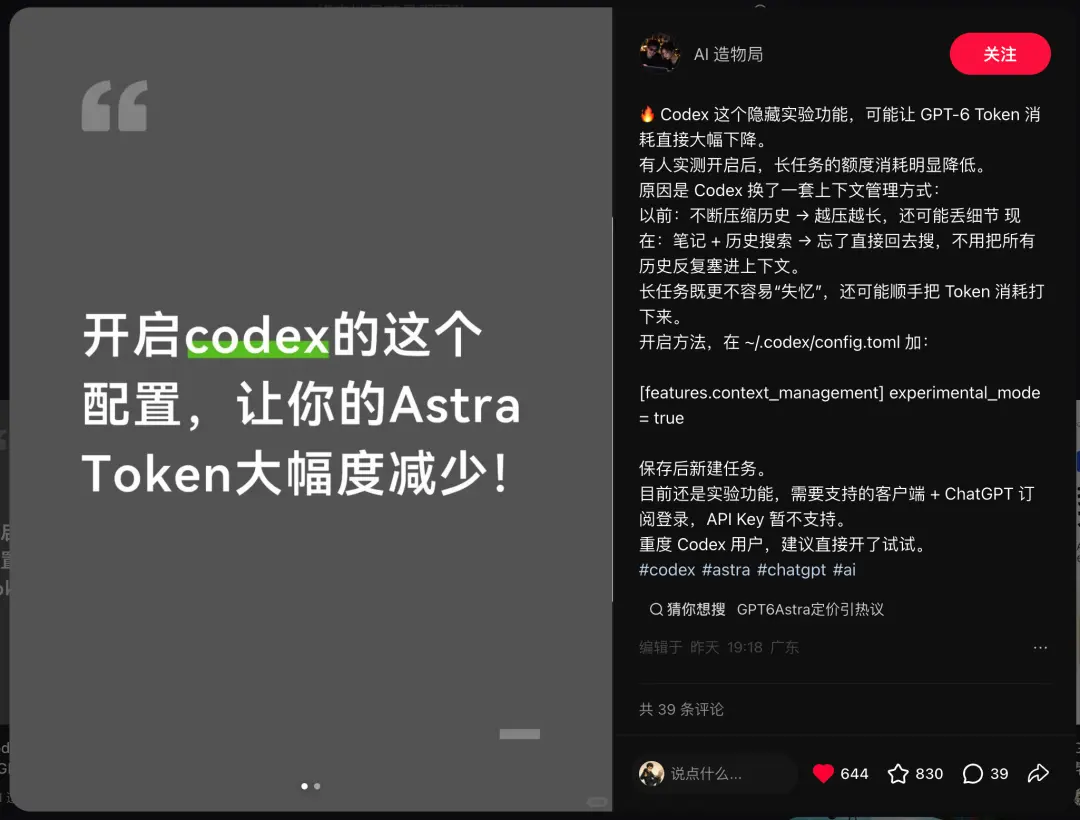
3. 开 context_management。 在 ~/.codex/config.toml 里加两行:[8][features.context_management]experimental_mode = true
保存后新建任务(目前还是实验功能,需要支持的客户端 + ChatGPT 订阅登录,API Key 暂不支持)。它把"不断压缩历史"换成"笔记 + 历史搜索",长任务既不容易失忆,token 消耗也降下来。周末在家里跑了一天,刷了一天的帖子和自己的反馈相互验证,得出这篇文章。回到开头那个问题——官方和营销号都在喊"删提示词、更新 AGENTS",到底是怎么回事?其实,真正的问题是:Astra 把你写的话当真了,所以该换的不是模型,是你写给旧模型的那套用法。- AGENTS 里模糊的"谨慎",逐条换成能执行的边界,拿官方提示词或卡兹克那版做底子;
- 额度分两套,订阅看条数、API 看 token,Astra 的条数省着用。
这四件做完,才算真正发挥出 Astra 的能力。不然就是花着 2.5 倍的价格,还在跑旧模型的用法。[1]: OpenAI,GPT-6 Astra 开发与迁移指南,developers.openai.com,访问 2026-09-06,https://developers.openai.com/api/docs/guides/latest-model?model=gpt-6-astra[2]: 小明同学有点东西,《GPT-6 Astra来了:别再死磕"完美提示词"了》,小红书,访问 2026-09-06,https://www.xiaohongshu.com/explore/6a9c3690000000002b01da70[3]: Aspirin,《GPT6官方文件明确表示,少用无效skill!》,小红书,访问 2026-09-06,https://www.xiaohongshu.com/explore/6a9bc2ed000000002a005793[4]: @Khazix0918,重写 GPT-6 Astra 版 AGENT.md 帖,X,2026-09-05,https://x.com/Khazix0918/status/2096125440893329685[5]: KevinTwo-抓住单词App,《GPT5.6子智能体变革,codex干活模式又变了》,小红书,2026-07-15,https://www.xiaohongshu.com/explore/6a5718ae0000000015024a0e[6]: 硅基纪元,《GPT5.6的子agent调用能力极大提升》,小红书,访问 2026-09-06,https://www.xiaohongshu.com/explore/6a504540000000000f005a77[7]: OpenAI,GPT-6 Astra 模型页,developers.openai.com,访问 2026-09-06,https://developers.openai.com/api/docs/models/gpt-6-astra[8]: AI 造物局,《Codex 这个隐藏实验功能,可能让 GPT-6 Token 消耗直接大幅下降》,小红书,访问 2026-09-06,https://www.xiaohongshu.com/explore/6a9bce82000000000b00d03e[9]: OpenAI,GPT-5.6 Sol 模型页,developers.openai.com,访问 2026-09-06,https://developers.openai.com/api/docs/models/gpt-5.6-sol