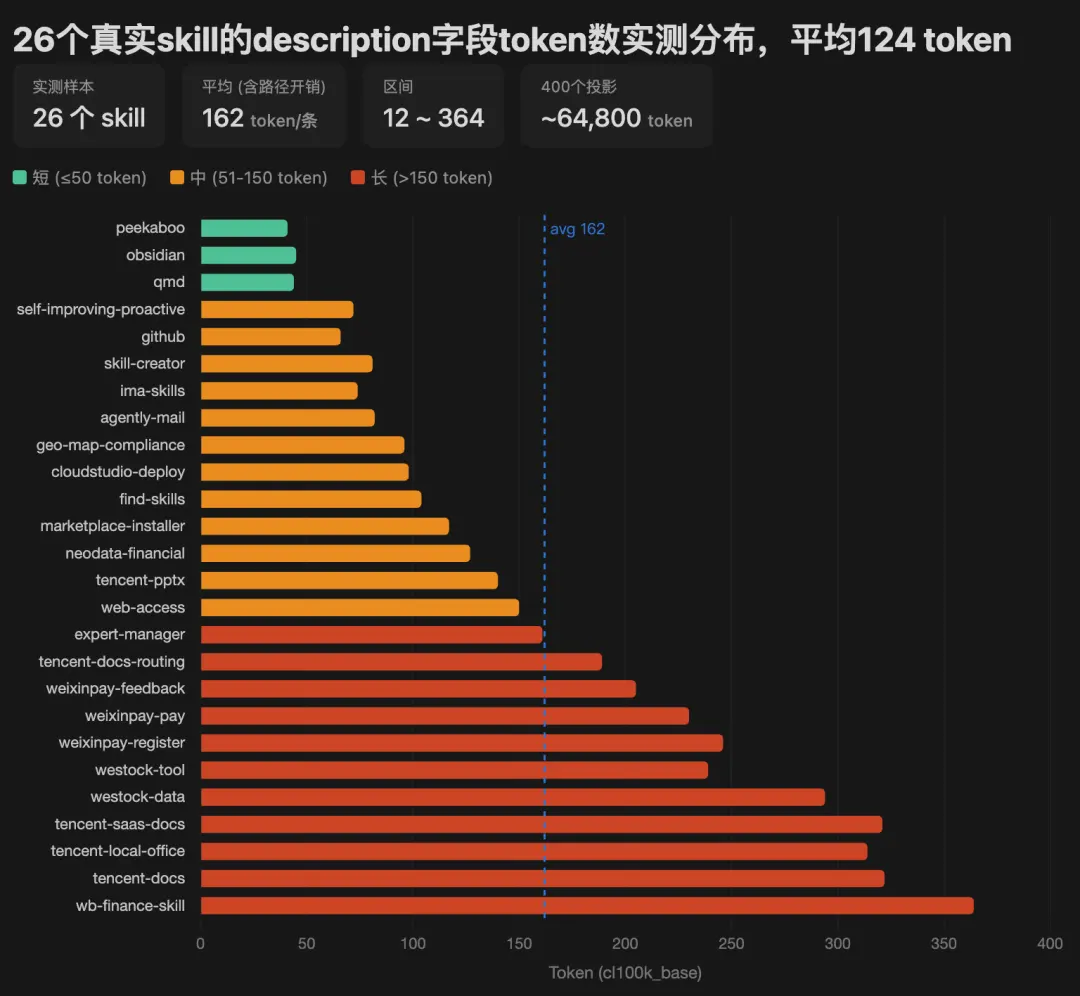
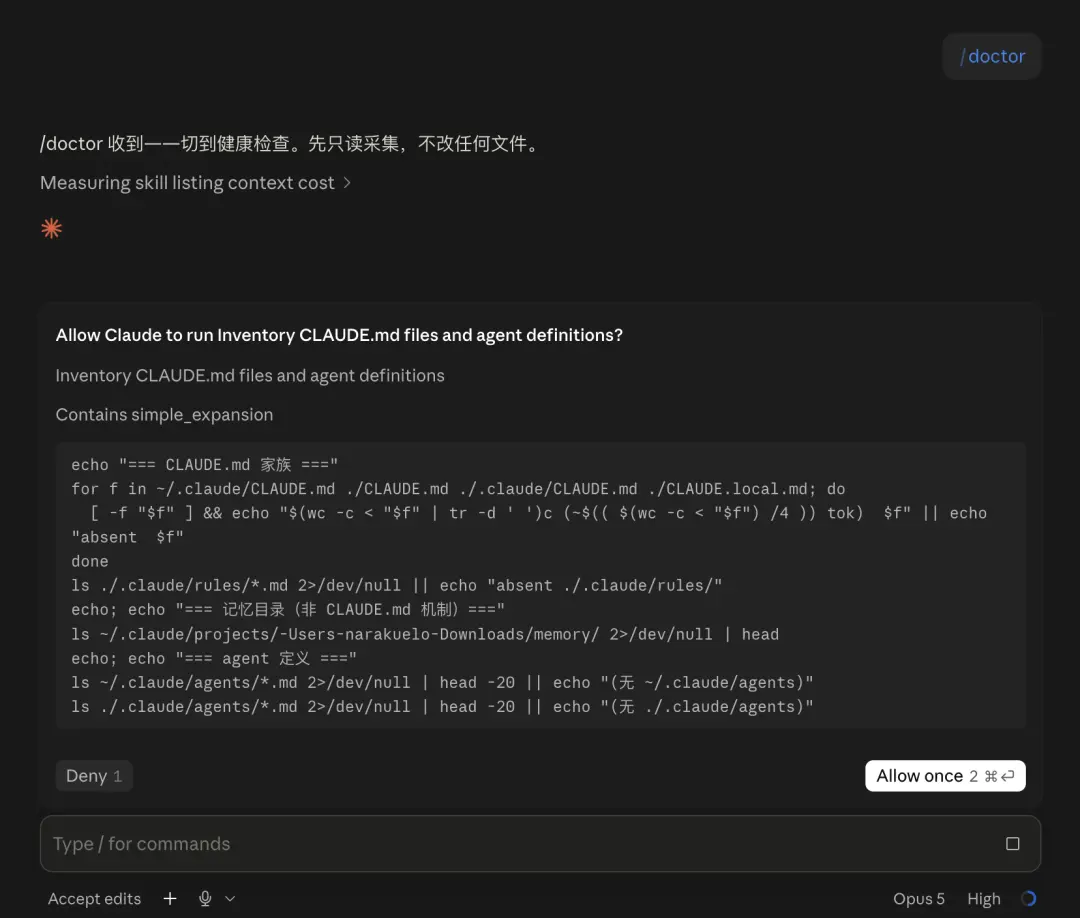
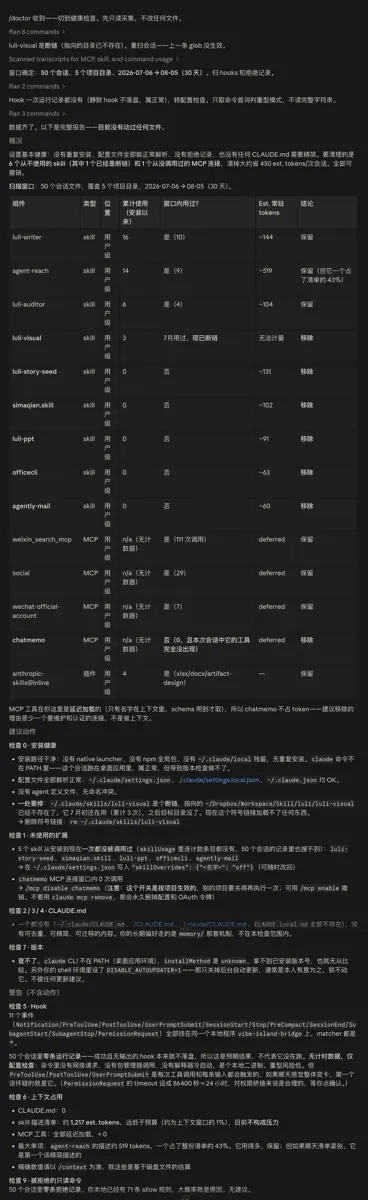
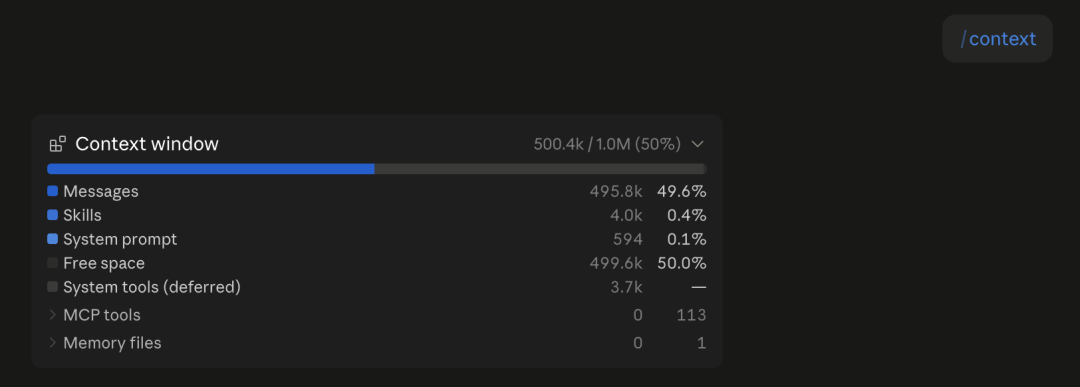
从去年11月份开始接触skill到现在,最多的时候快400个,到现在留着的不到30个。前段时间闲着没事,让 AI 把 Anthropic 那份《Extend Claude with skills》官方文档从头读了一遍,发现了一些之前营销号吹的错误观点,和自己实际做的过程中的一些错误做法,分享给大家。这一篇只针对 Claude 的 skill ,其他工具的可能有差异,辩证看待。 01.数量不是问题的关键 我们都知道skill是渐进式加载,官方文档是这样写的:In a regular session, skill descriptions are loaded into context so Claude knows what's available, but full skill content only loads when invoked.在常规会话里,只有 skill 的描述(description)会被加载进上下文,好让 Claude 知道有哪些能力可用;完整的 skill 内容只在被调用时才加载。还有一句更直接的:Unlike CLAUDE.md content, a skill's body loads only when it's used, so long reference material costs almost nothing until you need it.和 CLAUDE.md 里的内容不同,skill 的正文只在被使用时才加载,所以长篇的参考资料在你需要它之前,几乎不产生任何成本。意思是:你装 50 个 skill,常驻在上下文里的不是 50 个完整 skill 的内容,是 50 条 skill 的描述,和正文的长度无关;Skill 正文写1000行还是100行都不影响,不调用就不花钱。这就是所有讲 skill 的文章都在说:别装太多Skill,装多了吃上下文、模型会变笨 的原因。我自己也犯过错,在前面省 Token 的文章里写过"技能别装多"。最多的时候我装了快400个skill,我们按照一个skill的描述100 Token来算,100 * 400 = 40000 Token。也就是每次对话都有40000 Token的额外消耗(这还是比较理想的情况,不少skill的描述并不止是100字符,所以总数只会更多而不是更少)。 图1 26个真实skill的description字段token数实测分布,平均124 token那删掉保留10个,就是 10 * 100 = 1000 Token,只有原来的2.5%,就省下来大量的Token消耗。看起来好像没毛病?但如果这些skill都是有用的,舍不得删,怎么解? 真正的瓶颈:描述清单有预算,而且会被砍这才是真正的关键,官方写在 Troubleshooting 里,我没见国内文章提过:The listing always contains every skill name, but if you have many skills, Claude Code shortens descriptions to fit the listing's character budget, which can strip the keywords Claude needs to match your request. The budget scales at 1% of the model's context window. When the listing overflows, Claude Code drops descriptions starting with the skills you invoke least, so the skills you use most keep their full text.这份清单始终包含每一个 skill 的名字,但如果你的 skill 很多,Claude Code 会压缩描述来塞进清单的字符预算里,这可能会把 Claude 匹配你请求所需要的关键词一起删掉。这个预算是模型上下文窗口的 1%。当清单超出预算,Claude Code 会从你调用得最少的那些 skill 开始丢弃描述,好让你最常用的那些保住完整文本。把这段拆开看,会得到一个挺难受的循环:skill 装多了 → 描述清单超预算 → 系统从最少用的开始砍描述 → 描述被砍掉关键词之后更匹配不上 → 那个 skill 更不会被触发 → 它在"最少用"的名单上更靠前 → 下次砍得更彻底。一旦 skill 进入这个循环,它不是死于你不需要它,是死于它没机会被AI用起来。顺带说一句,清单里名字始终都在——所以就算描述被砍光,你手动敲技能的名字还是能调起来。——注意,后面要考。 怎么查自己的实际占用官方给了两个可以直接跑的命令:Run /doctor for an estimate of the listing's context cost and its biggest contributors.运行 /doctor 可以估算这份清单的上下文成本,以及哪几个 skill 是最大的贡献者。 图2 使用 /doctor 查询,中间会弹出好多次权限确认 图3 /doctor 查询结果展示,可以清理掉不常用的和有问题的 skill/context 里也有专门的一行:The Skills row in /context reports the size of the listing after the budget is applied, so it matches what the model receives./context 里的 Skills 那一行,报告的是套用预算之后的清单大小,所以它和模型实际收到的内容是一致的。 图4 /context 命令后显示的效果,可以看到skill占用基本在1%以内先跑 /doctor 看谁在占地方,再决定砍谁——这个顺序比凭感觉删靠谱得多。我自己最多的时候装过差不多 400 个,现在 Claude 这边留了 9 个、Codex 那边 22 个(有几个系列是Claude、Codex两边都有重复)。 描述有 1,536 字符硬上限官方文档是这样说的:put the key use case first, since each entry's combined text is capped at 1,536 characters regardless of budget.把最关键的使用场景写在最前面,因为每一条的合并文本(description 加 when_to_use)无论预算多少,都被硬性截断在 1,536 字符。注意这是"无论预算多少"——就算你把预算调大,单条超过 1,536 字符的部分照样没了。所以,这就是好多Skill教程要求描述别写成说明书,把"什么时候该用我"放第一句的核心原因。那这里的字数实在不够,或者要用的skill确实太多,咋整?官方给了几个口子:skillListingBudgetFraction(比如设成 0.02 就是 2%)、环境变量 SLASH_COMMAND_TOOL_CHAR_BUDGET(定死字符数)、skillListingMaxDescChars(改那个 1,536 的上限)。 还有个坑:YAML 写坏了不会报错If the frontmatter YAML is malformed, Claude Code loads the skill body with empty metadata, so /skill-name still works but Claude has no description to match against. Run with --debug to see the parse error.如果 frontmatter 的 YAML 格式有问题,Claude Code 会带着空的元数据加载 skill 正文——所以 /skill-name 手动调用照样能用,但 Claude 手里没有 description 可以拿来匹配。用 --debug 运行可以看到解析错误。这个坑的恶心之处在于:它不报错!!你手动调一切正常,就是自动触发死活不灵。所以如果碰到"我这个 skill 怎么从来不自己启动",先 --debug 看一眼 YAML再说。 02.它不是一直在听你的 前段时间有AI的营销号在吹,说是大模型能力越变越强之后,提示词、SKill之类的就已经不管用了(就是说已经被大模型吸收内化掉了,就没必要再阐述一遍)。但根据自己实际使用的经验,包括在使用Fable 5的时候,大模型确实有不调用skill的情况(很自信),但执行效果还是有很大差异,至少当前阶段还是需要skill的约束的。 Skill 被调用之后,文件就不再读了这条我觉得是整篇最值钱的:When you or Claude invoke a skill, the rendered SKILL.md content enters the conversation as a single message and stays there for the rest of the session. ... Claude Code does not re-read the skill file on later turns, so write guidance that should apply throughout a task as standing instructions rather than one-time steps.当你或 Claude 调用一个 skill 时,渲染后的 SKILL.md 内容会作为一条消息进入对话,并在这次会话的剩余时间里一直待在那儿。……Claude Code 不会在后续轮次重新读取 skill 文件,所以那些需要贯穿整个任务的指导,要写成常驻指令,而不是一次性步骤。这句话改变了写法。很多人(包括我一开始)是按"操作手册"的思路写 skill 的:第一步做什么、第二步做什么。但模型只在调用那一刻读一次,后面它面对的是对话里那一条静态消息。所以凡是希望它全程守住的东西——比如"每一步都要停下来等确认""引用必须回原文核对"——要写成贯穿性的规矩,而不是流程里的某一步。写成第几步,它跑到第五步的时候早忘了。 用着用着就不听话了,是有原因的If a skill seems to stop influencing behavior after the first response, the content is usually still present and the model is choosing other tools or approaches.如果一个 skill 看起来在第一次回应之后就不再影响行为了,通常内容其实还在,只是模型选择了别的工具或方法。更麻烦的是上下文被压缩之后:When the conversation is summarized to free context, Claude Code re-attaches the most recent invocation of each skill after the summary, keeping the first 5,000 tokens of each. Re-attached skills share a combined budget of 25,000 tokens. Claude Code fills this budget starting from the most recently invoked skill, so older skills can be dropped entirely after compaction if you have invoked many in one session.当对话被压缩总结以腾出上下文时,Claude Code 会在总结之后重新附上每个 skill 最近一次调用的内容,每个只保留前 5,000 tokens。这些被重新附上的 skill 共享 25,000 tokens 的总预算。Claude Code 从最近调用的那个开始填这个预算,所以如果你在一次会话里调用了很多 skill,比较早的那些在压缩之后可能被整个丢掉。翻译成人话就是:长会话里你调了五六个 skill,压缩一次之后,最早那个可能已经完全不在了;就算还在,也只剩前 5,000 tokens——你写在文件后半部分的规矩,压缩后大概率没了。官方给的办法是:If the skill is large or you invoked several others after it, re-invoke it after compaction to restore the full content.如果这个 skill 比较大,或者你在它之后又调用了好几个别的,在压缩之后重新调用一次,把完整内容找回来。所以长任务里,看到上下文压缩过,顺手把主 skill 再调一次,比你反复追问"你是不是忘了规矩"有用。还有一条版本相关的,用老版本的人要注意:Before v2.1.202, every re-invocation appended another full copy of the skill's instructions.在 v2.1.202 之前,每一次重新调用都会再追加一份完整的 skill 指令副本。也就是说旧版本里反复调同一个 skill,是在不停地往上下文里堆重复内容。新版本会识别出内容相同,只加一句"已加载"的提示。 03.大多数时候你不需要删 回到第一节那个机制:占地方的是描述清单,不是 skill 本身。而官方给了两个开关,可以让一个 skill 留着但不占清单预算。第一个是 frontmatter 里的字段:disable-model-invocation: true — You can invoke: Yes / Claude can invoke: No / Description not in context, full skill loads when you invokedisable-model-invocation: true —— 你可以手动调用:能 / Claude 自动调用:不能 / 描述不进上下文,完整 skill 在你手动调用时才加载。第二个是设置里的:To free budget for other skills, set low-priority entries to "name-only" in skillOverrides so they list without a description.想给别的 skill 腾预算,就在 skillOverrides 里把低优先级的条目设成 "name-only",这样它们只列出名字、不带描述。这两个的效果是一样的:这个 skill 还在,你随时能敲 /名字 调它,但它不再占用那份宝贵的描述预算,也不会再被自动触发。对那些"一年用一次但用到时很关键"的 skill,这才是正确处理方式。直接删掉,等于把一份已经写好的东西扔了,下次还得重写。 什么时候是真该删我的判断很简单,就两条:1. 这个 skill 你从来没打开过第二次。 装的时候觉得会用上,之后再没想起来——不是它不好,是它解决的问题在你这儿不存在。比如N个营销号在推荐的 superpowers 框架,后来我让AI给我分析,我自己的使用习惯、场景完全用不到,在使用的时候反而会增加Token消耗带来其他不必要的麻烦,后来我就删掉了整个框架,一样用得很好。这是著名的剃刀定律:如无必要勿增实体。2. 功能重复,场景小众。 这种问题可太多了——基本上每个人都装了几个写作的、抓信息的,或者是做PPT的,但实际上真正用的时候并没有那么多。大部分人写PPT也就一个月一两次,写作的说不定自建的更好;所以重复的就没有必要了。从几百个删到十几个之后,我留下的基本只有两类:自己写的,和天天用的。 04.我自己踩出来的经验 前面的这些全是官方文档里能查到的。这一节没有出处,是我维护自己 skill 攒下来的经验,可以参考。 给自己的 Skill 加更新日志我给自己的 skill 建了一个 CHANGELOG.md,每次改动记三件事:改了什么、依据是什么、为什么这么改。到现在跑到了 3.2 版。记依据这件事,一开始觉得多余,后来发现是最有用的。因为过几个月回头看,"当时为什么加这条规则"这个问题,光看规则本身是答不出来的。而答不出来的规则,你就不敢删——只能一直留着,越堆越多。比如 3.0 那次大改,我在依据里写的是"某篇文章写崩了,根因是 skill 臃肿到跳读"。有这句话在,我以后就知道这套结构是为了解决什么问题存在的,哪天问题不存在了,可以整个拿掉。 学思路,而不是照抄这条我觉得比上一条更重要。外面有太多大神了,好东西都是别人造了不知道多少次的轮子。所以看到好的经验、方法,都希望合并进自己的skill里,但问题是:搬进来的东西带着它原来场景的假设,用在自己身上就变形了。栽过几次(AI都提醒skill里有冲突了,导致无所适从),后来我加了一条规则:外部方法要进来,先判断它原本是为什么场景设计的,那个场景和我的一样吗。不一样就砍掉,而且把砍掉的理由也记进 CHANGELOG。记下来的好处是:下次再看到同类方法,直接对照,不用重新纠结一遍。 减法也会砍错加多了容易出问题,砍内容的时候尤其需要注意。前段时间做结构精简,一口气标了差不多 20 处"重复、待删"。真动手之前又复核了一遍,发现大部分根本不是重复——它们是路由提示、是在关键动作旁边的防呆设计(就是防止自己手贱的),删了以后模型在那个位置就没有约束了。最后真正删掉的,只有"整条规则在第二个文件里被完整写了一遍"那几处。所以精简 skill 的标准不是"这句话前面出现过",而是"这一整条规则有没有在别处被完整地写了第二遍"。提示和复述是两回事。 参考资料[1]: Anthropic,《Extend Claude with skills》,Claude Code 官方文档,访问 2026-08-05,https://code.claude.com/docs/en/skills