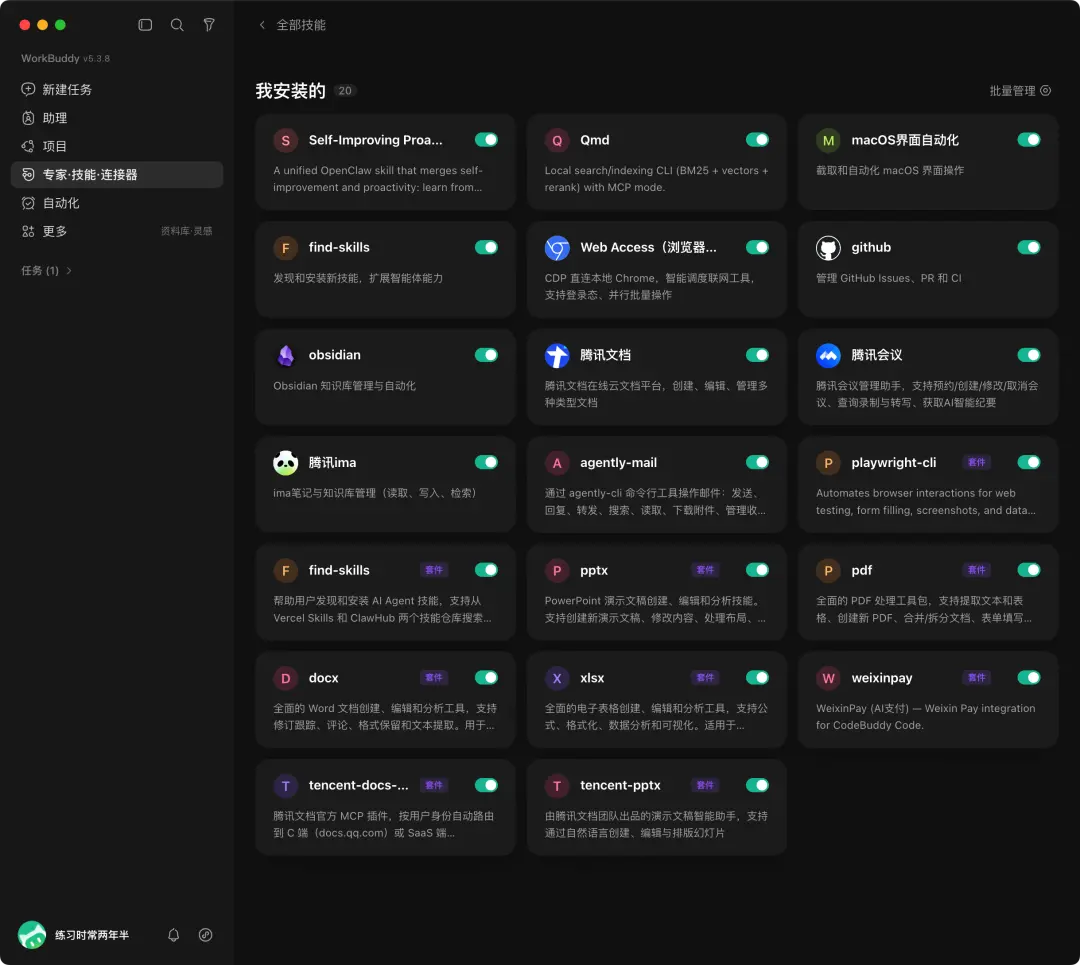
Skill 经验分享:4 道坎,3 个不报错 软链接 + Dropbox,我是这么管几个工具的 Skill 的 2026.08.06 公众号原文 上一篇只讲了 Claude,开始我就强调了"其他工具的可能有差异,辩证看待"。这篇就是那个差异。我的实际处境是两台电脑(公司的 Mac Mini、自己的 MacBook Pro),每台上面又装着好几个工具。Claude 这边留了 9 个 skill,Codex 那边 22 个,其中有 4 个是同一份东西(我自己写的skill,实际上Workbuddy也在用)。用了这么几个月,我的结论是:一个 skill 想在多个工具里通用,理论上可以,实际上有四道坎。01.第一道坎:路径各写各的skill的安装路径都是.agents/skills这个通用路径,但Claude是个例外:产品用户级项目级Claude Code~/.claude/skills.claude/skillsOpenAI Codex$HOME/.agents/skills.agents/skillsCursor~/.agents/skills、~/.cursor/skills.agents/skills、.cursor/skillsCursor 是里面最宽容的,它连别家的目录都读(笑S,没有自家的模型就只能兼容所有的):Cursor also supports .claude/skills/ and .codex/skills/ for compatibility.Cursor 出于兼容考虑,同样支持 .claude/skills/ 和 .codex/skills/。Codex 那边还多一层,它会从当前目录一路往上找:$CWD/.agents/skills → $CWD/../.agents/skills → $REPO_ROOT/.agents/skills → $HOME/.agents/skills → /etc/codex/skills国内的Workbuddy就不一样了,它需要单独导入一遍,不会自动扫描(这个真不想吐槽,奈何其他家不给力): 图1 Workbuddy安装后的技能截图,大部分是自带的Trae已经好久不用了,不知道现在的近况,不讨论。我的解法:源文件放 Dropbox,各家目录里做软链接既然路径不一样,产品也不一样,咋整?我是这样做的:skill 的源文件全部放在 Dropbox 里,然后在每个产品自己的 skill 目录下,创建一个软链接指回去。好处是两层的:1. 一次更新多个工具同步。 同一份源文件,Claude 和 Codex 各自链一次,改一次两边都生效,不用维护两份(我现在有 4 个 skill 是这个状态)2. 跨网络跨环境。 Dropbox 本来就在两台机器之间同步,所以笔记本上改完,Mini 上打开就是新的。不用手动CV一遍,也不会出现"这台是 3.1 版那台还是 3.0 版"(其实如果是win和mac系统的话,好像也是可以的)。但这套方案有个不报错的坑前几天我做了一次体检,发现 ~/.claude/skills 里有一个软链接指向 Dropbox 里一个已经不存在的目录。目录还在,名字还在,看起来一切正常。但软链接是死的,Claude 加载不了任何东西——它不会报错。我还奇怪这是个啥问题,让AI分析了一通,后来反应过来,纯粹是自己手贱在另一台电脑删除了,然后本机的软链接指向为空。问题不大,一条命令就能全揪出来:Bash复制1find ~/.claude/skills ~/.codex/skills -maxdepth 1 -type l ! -exec test -e {} \; -print输出的就是所有指向已消失目录的软链接。想看清楚它原本指向哪儿,用这个:Bash复制12345for d in ~/.claude/skills ~/.codex/skills; dofind "$d" -maxdepth 1 -type l | while read l; do[ -e "$l" ] || echo "断链: $l -> $(readlink "$l")"donedone我那个跑出来是这样的:Code复制1断链: /Users/narakuelo/.claude/skills/luli-visual -> /Users/narakuelo/Dropbox/Workspace/Skill/luli/luli-visual跑 /doctor 也能顺带发现(我就是这么撞见的),但它不会明说是断链,得自己看指向。所以每次在 Dropbox 那边整理完目录,顺手跑一下上面那条命令比较省事。02.第二道坎:预算不一样,溢出之后的行为差得更远上一篇讲过 Claude 的描述清单预算是上下文窗口的 1%。Codex 那边是另一个数:To avoid crowding out the rest of the prompt, this list uses at most 2% of the model's context window, or 8,000 characters when the context window is unknown.为了不把提示词的其他部分挤掉,这份清单最多占用模型上下文窗口的 2%,或者在窗口大小未知时占 8,000 字符。2% 比 1% 宽松一倍。但真正要命的不是这个数,是超了之后各自怎么处理。Claude 的做法上一篇引过:从你调用得最少的那些开始丢描述,名字永远保留——所以最惨的情况是自动触发失灵,但你手动敲名字还能调起来。Codex 是这样:Codex shortens skill descriptions first. For large skill sets, Codex may omit some skills from the initial list and show a warning.Codex 会先压缩 skill 的描述。对于数量很大的 skill 集合,Codex 可能会从初始清单里省略掉一部分 skill,并给出一个警告。问题就很明显了:Claude 是它想不起来用,Codex 是它压根不知道有这个东西。后者更难发现。Claude 那种情况你还能手动敲名字把它调起来,至少东西还在;Codex 直接从清单里省略,你得先自己意识到"我明明装了这个",才会想到去查。好在官方说了这种情况会给一个警告——Codex 那边装得多的话,启动时留意一下有没有这条。03.第三道坎:优先级方向是反的这条最容易在团队里出事。Claude 的规则是:When skills share the same name across levels, enterprise overrides personal, and personal overrides project.同名 skill 跨层级时,企业级覆盖个人级,个人级覆盖项目级。注意后半句——你放在个人目录里的,会盖掉项目里的那个。Codex 的发现顺序则是仓库级在前、用户级在后,和 Claude 正好相反。也就是说,同一套 skill 搬到不同工具里,谁盖谁是反过来的。你在 Claude 里习惯了"我个人的设置说了算",到 Codex 里就变成"项目里的说了算"。这个差异平时看不出来,只有当项目里和个人目录里存在同名 skill 时才会暴露——而且暴露的方式是"它执行的不是我以为的那一份",同样不报错。太阴险了,多注意。04.第四道坎:字段各家各写各的Skill 这套格式本身是有标准的——Anthropic 做出来之后开源成了 Agent Skills 开放标准,现在 Cursor、Codex、Gemini CLI、GitHub Copilot 这些都按它来实现。标准定得很克制,一共就六个字段:name 和 description 必填,license、compatibility、metadata、allowed-tools 可选。实际上呢:Claude 的 frontmatter 有二十多个字段:when_to_use、argument-hint、arguments、disable-model-invocation、user-invocable、allowed-tools、disallowed-tools、model、effort、context、agent、background、hooks、paths、shell……Codex 走的是另一条路——frontmatter 只留 name 和 description,其他的全挪到一个单独的文件 agents/openai.yaml 里(Codex的skill会单独创建一个目录和一个 openai.yaml 文件):YAML复制12345678interface:display_name: "..."icon_small: "./assets/small-logo.svg"brand_color: "#3B82F6"policy:allow_implicit_invocation: true/falsedependencies:tools: [...]那个 policy.allow_implicit_invocation,作用和 Claude 的 disable-model-invocation 是一回事(控制模型能不能自动调用它),但一个在 frontmatter、一个在单独的 yaml 里。Cursor 支持的字段里有 paths 和 disable-model-invocation,名字和 Claude 一样。所以结论是:你在 Claude 里写的那些高级字段,搬到别的工具就是一行死字段。 不报错、不生效、也不提示你(这是第三个"不报错"了)。还有一个数字对不上上面说的那个 Agent Skills 标准,规定 description 最多 1024 字符:description | Yes | Max 1024 characters. Non-empty.description:必填,最多 1024 字符,不能为空。Claude 的实际实现是:each entry's combined text is capped at 1,536 characters regardless of budget每一条的合并文本(description 加 when_to_use)无论预算多少,都被硬性截断在 1,536 字符。1024 和 1536,差了 512。如果你按 Claude 的上限把描述写到 1500 字符,它在 Claude 里是完整的,但已经超出标准 400 多字符——搬到严格按标准实现的工具里,超出的部分会怎么样,得看那家自己的处理。反过来,如果你老老实实按 1024 写,在 Claude 里就有1/3的额度没用上。05.我的做法总结skill 源文件放在 Dropbox 里,自己分好类。需要哪个工具用,就在那个工具的 skill 目录里做一个软链接。Claude 和 Codex 两边都要的,就链两次。Wordbuddy单独导入一次(大坑,不用可以不管)。Skill的描述按 1024 字符的标准写,不用 Claude 那个 1536。Claude 特有的那些字段,只在明确"这个 skill 就只给 Claude 用"的时候才写;打算多处通用的,就只用标准里那六个字段。参考资料[1]: Agent Skills,《Specification》,agentskills.io,访问 2026-08-05,https://agentskills.io/specification[2]: Anthropic,《Extend Claude with skills》,Claude Code 官方文档,访问 2026-08-05,https://code.claude.com/docs/en/skills[3]: OpenAI,《Build skills》,ChatGPT 与 Codex 官方文档,访问 2026-08-05,https://learn.chatgpt.com/docs/build-skills[4]: Cursor,《Skills》,Cursor 官方文档,访问 2026-08-05,https://cursor.com/docs/context/skills